原始链接在: 大语言模型最喜欢哪种表格格式?Markdown、CSV、JSON、XML、YAML… - 小众软件
在向大语言模型提供表格数据时,不同格式的内容对于结果与 token 的消耗非常不同,如果能够选择合适的格式,将获得翻倍的准确率,但也可能消耗更多的 token。@Appinn
improvingagents 针对这一问题进行了测试,结果表示:
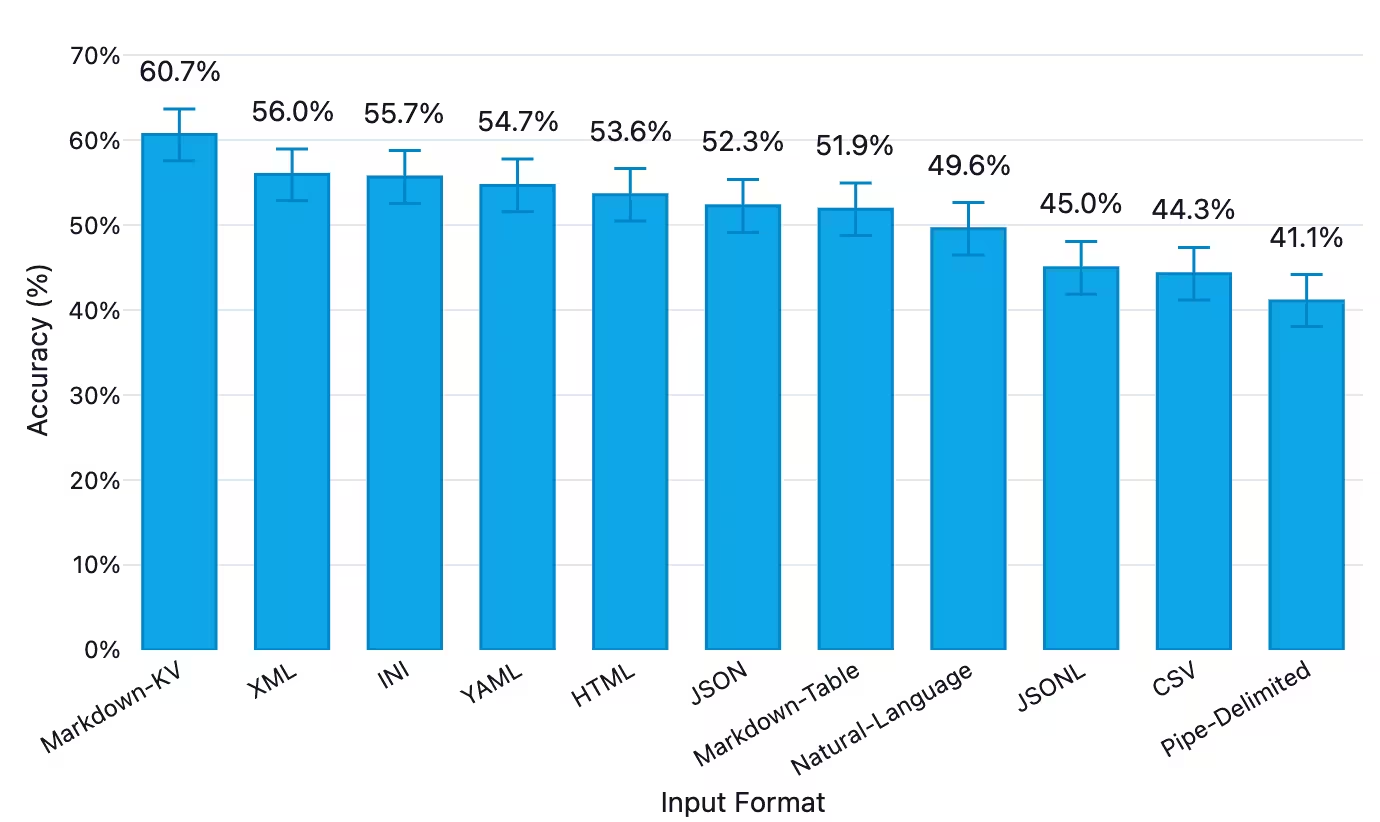
- Markdown-KV(Markdown格式的“key: value”键值对)准确率最高(60.7%),但消耗token最多,比最省token的CSV多2.7倍。
- CSV 和 JSONL 格式,但准确率偏低(分别为44.3%、45%),建议避免默认采用。
- 在需要兼顾可读性和成本时,可以考虑Markdown表格(准确率51.9%,token消耗较低)。
具体测试
使用 GPT-4.1-nano 模型,11 种不同格式(markdown-kv、xml、ini、yaml、html、json、markdown-table、自然语言、JSONL、CSV、Pipe-Delimited)
数据集
将 1000 个记录传递给 LLM(大语言模型),并要求它根据数据回答问题,然后评估了准确率。
具体数据包括1000个记录,每个记录8个属性(ID,名称,年龄,城市,部门,薪金,经验,项目计数)
人类最喜欢看的表格格式:
| ID | 姓名 | 年龄 | 城市 | 部门 | 薪水 | 工作经验 | 项目数量 |
|---|---|---|---|---|---|---|---|
| 1 | Diana A0 | 46 | London | 工程部 | 141015 | 7 | 17 |
| 2 | Grace B1 | 59 | Berlin | 市场部 | 100066 | 11 | 32 |
| 3 | Grace C2 | 64 | Dubai | 销售部 | 91727 | 9 | 49 |
示例问题(一共1000个问题)
Q. “Grace X413拥有多少年工作经验?(仅返回数字,例如’12’。)”
A. “15”
Q. “Alice W204的薪资是多少?(仅返回数字,例如’85200’。)”
A. “131370”
测试结果
| 格式 | 准确性 | 95%置信区间 | 消耗 Tokens |
|---|---|---|---|
| Markdown-KV | 60.7% | 57.6% – 63.7% | 52,104 |
| XML | 56.0% | 52.9% – 59.0% | 76,114 |
| INI | 55.7% | 52.6% – 58.8% | 48,100 |
| YAML | 54.7% | 51.6% – 57.8% | 55,395 |
| HTML | 53.6% | 50.5% – 56.7% | 75,204 |
| JSON | 52.3% | 49.2% – 55.4% | 66,396 |
| Markdown-Table | 51.9% | 48.8% – 55.0% | 25,140 |
| Natural-Language | 49.6% | 46.5% – 52.7% | 43,411 |
| JSONL | 45.0% | 41.9% – 48.1% | 54,407 |
| CSV | 44.3% | 41.2% – 47.4% | 19,524 |
| Pipe-Delimited | 41.1% | 38.1% – 44.2% | 43,098 |
Markdown-KV 是什么?
其实青小蛙此前也不太理解 kv 是什么。
Markdown-KV 是指一种在 Markdown 文档中采用“key: value”键值对的表示格式,用以组织结构化数据(例如每条记录的属性和数值)。这种格式并不是 Markdown 官方标准,而是社区和开发实践中广泛使用的一种便于人工和模型理解的数据排列方式。
# Employee DatabaseRecord 1
id: 1 name: Charlie A0 age: 56 city: New York department: Operations salary: 67896 years_experience: 7 project_count: 1Record 2
id: 2 name: Grace B1 age: 59 city: Mumbai department: Marketing salary: 47248 years_experience: 0 project_count: 43Record 3
id: 3 name: Eve C2 age: 50 city: Singapore department: Sales salary: 102915 years_experience: 14 project_count: 11
局限性
仅测试了 GPT-4.1 nano,以及一种数据结构。数据量较大,可能会造成干扰。
结束
如果你有类似的数据需要大语言模型进行处理,可以先使用大语言模型将数据转换为 Markdown-KV 之后,再进行提问。
更多细节可以前往 improvingagents 阅读。
原文:https://www.appinn.com/llm-favorite-table-format/
关注我们
- 微博:https://weibo.com/appinncom
- B站:https://space.bilibili.com/10979326
- 小红书:https://kutt.appinn.com/6QwshF
- Facebook:https://www.facebook.com/appinncom/
- BlueSky:https://bsky.app/profile/appinn.bsky.social
- X:https://x.com/appinn
- 微信公众号:搜索「小众软件」
- TG频道:@appinnfeed
爱发电:https://afdian.com/a/qingxwa (打赏我们,让我们更好的创作)